 create-docs
1. let、var、const 的区别
var
- 没有块级作用域的概念
- 有全局作用域、函数作用域的概念
- 不初始化值默认为 undefined
- 存在变量提升,提升至当前作用域的顶层
- 全局作用域用 var 声明的变量会挂载到 window 对象下
- 同一作用域中允许重复声明
let
- 有块级作用域的概念
- 不存在变量提升
- 暂时性死区
- 同一块作用域中不允许重复声明
const
- 与 let 特性一样,仅有 2 个差别
- 区别 1:必须立即初始化,不能留到以后赋值
- 区别 2:常量的值不能改变
2. JS 中的数据类型
两大类型
① 基础数据类型
number、string、boolean、null、undefined、symbol、binInt
tips1
symbol:主要用于创建唯一的标识符。symbol 的值是唯一且不可变的,适用于作为对象属性的键,以及保证不会与其他属性键发生冲突,特别是在多人合作的大型项目中或者当你使用第三方库的时候
binInt:大整数,即大于 2^53 - 1或小于-2^53 + 1的整数。这个类型提供了一种在 JS 中安全处理非常大的整数的方法,。这种类型非常适合于用在金融、科学计算和加密等领域
tips2
null:
1)从语义上来讲就是表示对象的 “无”
2)转为数值时会被转换为 0
3)作为原型链的终点
undefined:
1)从语义上来讲就是表示简单值的“无”
2)转为数值为 NaN
3)变量声明了没有赋值,那么默认值为 undefined
4)调用函数没有提供要求的参数,那么该参数就是 undefined
5)函数没有返回值的时候,默认返回 undefined
② 引用数据类型
object,像 array、function、regxp 都属于 object
TIP
在函数内部有一个特别的内部属性 [[Call]],这个是属于内部代码,开发者层面是没有办法调用的。但是有了这个属性之后,表示这个对象是可以被调用。
因为函数是可调用的对象,为了区分 普通对象 和 函数对象,因此当我们使用 typeof 操作符检测一个函数时,它返回的是 function。
也正因为这种设计,所以 JS 中能够实现高阶函数。高阶函数的定义:
- 接受一个或多个函数作为输入
- 输出一个函数
因为在 JS 中,函数的本质就是对象,因此可以像其他普通对象一样,作为参数或者返回值进行传递。这也是 JS 中所说的函数是一等公民这个说法的由来。
二者的本质区别
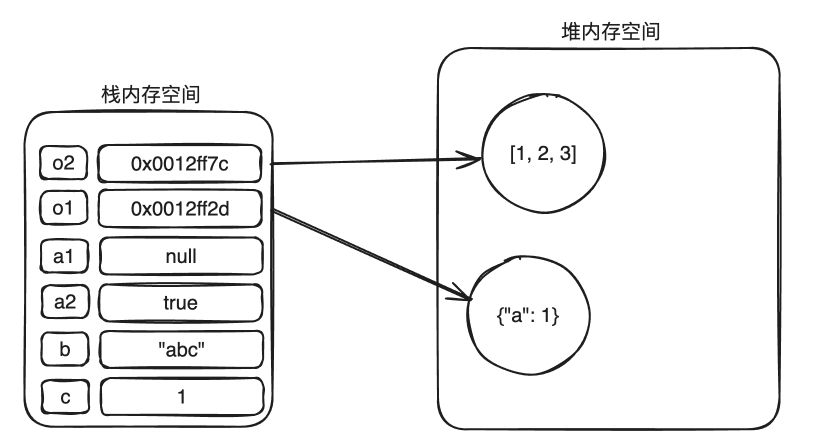
简单数据类型存储在栈内存中,存储的是实际值
引用数据类型同时存储在栈内存和堆内存中,栈内存存储的是内存地址(这个地址指向堆内存的实际值),堆内存存储的是实际值
3. 判断数据类型
typeof
能判断出四种,分别是 number,string,boolean,object,剩余的均被检测为 object
instanceof
判断参照对象的 prototype 属性所指向的对象是否在被行测对象的原型链上
constructor
针对于 instanceof 的弊端,我们使用 constructor 检测,constructor 是原型对象的属性指向构造函数
这种方式解决了 instanceof 的弊端,可以检测出除了 undefined 和 null 的 9 种类型
Object.prototype.toString.call
Object.prototype.toString 可以取得对象的内部属性[[class]],并根据这个内部属性返回诸如"[object Number]"的字符串,那么我们就可以通过 call 获取内部属性[[class]]
4. 如何让下述代码成立
if(a == 1 && a == 2 && a == 3){
 	console.log(1);
}
if(a == 1 && a == 2 && a == 3){
console.log(1);
}利用对象的 valueOf 方法(调用对象,实际上就是调用其原型上的 valueOf 方法)
TIP
var a = {
 i: 1,
 valueOf() {
     return a.i++
 }
}
var a = {
i: 1,
valueOf() {
return a.i++
}
}5. 对 JS 垃圾回收机制的理解
浏览器的 Javascript 具有自动垃圾回收机制(GC:Garbage Collecation),也就是说,执行环境会负责管理代码执行过程中使用的内存。其原理是:垃圾收集器会定期(周期性)找出那些不在继续使用的变量,然后释放其内存。
但是这个过程不是实时的,因为其开销比较大并且 GC 时停止响应其他操作,所以垃圾回收器会按照固定的时间间隔周期性的执行。
不再使用的变量也就是生命周期结束的变量,当然只可能是局部变量,全局变量的生命周期直至浏览器卸载页面才会结束。局部变量只在函数的执行过程中存在,而在这个过程中会为局部变量在栈或堆上分配相应的空间,以存储它们的值,然后在函数中使用这些变量,直至函数结束,而闭包中由于内部函数的原因,外部函数并不能算是结束。
标记清除
JavaScript 中最常用的垃圾回收方式就是标记清除。
当变量进入环境时,例如,在函数中声明一个变量,就将这个变量标记为“进入环境”。
从逻辑上讲,永远不能释放进入环境的变量所占用的内存,因为只要执行流进入相应的环境,就可能会用到它们。
而当变量离开环境时,则将其标记为“离开环境”。
function test() {
  var a = 10 // 被标记 ,进入环境
  var b = 20 // 被标记 ,进入环境
}
test() // 执行完毕 之后 a、b 又被标离开环境,被回收。
function test() {
var a = 10 // 被标记 ,进入环境
var b = 20 // 被标记 ,进入环境
}
test() // 执行完毕 之后 a、b 又被标离开环境,被回收。垃圾回收器在运行的时候会给存储在内存中的所有变量都加上标记(当然,可以使用任何标记方式)。
然后,它会去掉环境中的变量以及被环境中的变量引用的变量的标记(闭包)。而在此之后再被加上标记的变量将被视为准备删除的变量,原因是环境中的变量已经无法访问到这些变量了。
最后,垃圾回收器完成内存清除工作,销毁那些带标记的值并回收它们所占用的内存空间。
到目前为止,IE9+、Firefox、Opera、Chrome、Safari 的 JS 实现使用的都是标记清除的垃圾回收策略或类似的策略,只不过垃圾收集的时间间隔互不相同。
引用计数
引用计数的含义是跟踪记录每个值被引用的次数。
当声明了一个变量并将一个引用类型值赋给该变量时,则这个值的引用次数就是 1。如果同一个值又被赋给另一个变量,则该值的引用次数加 1。
相反,如果包含对这个值引用的变量又取得了另外一个值,则这个值的引用次数减 1。当这个值的引用次数变成 0 时,则说明没有办法再访问这个值了,因而就可以将其占用的内存空间回收回来。
这样,当垃圾回收器下次再运行时,它就会释放那些引用次数为 0 的值所占用的内存。
function test() {
  var a = {} // a 指向对象的引用次数为 1
  var b = a // a 指向对象的引用次数加 1,为 2
  var c = a // a 指向对象的引用次数再加 1,为 3
  var b = {} // a 指向对象的引用次数减 1,为 2
}
function test() {
var a = {} // a 指向对象的引用次数为 1
var b = a // a 指向对象的引用次数加 1,为 2
var c = a // a 指向对象的引用次数再加 1,为 3
var b = {} // a 指向对象的引用次数减 1,为 2
}Netscape Navigator3 是最早使用引用计数策略的浏览器,但很快它就遇到一个严重的问题:循环引用。
循环引用指的是对象 A 中包含一个指向对象 B 的指针,而对象 B 中也包含一个指向对象 A 的引用。
function fn() {
  var a = {}
  var b = {}
  a.pro = b
  b.pro = a
}
fn()
function fn() {
var a = {}
var b = {}
a.pro = b
b.pro = a
}
fn()以上代码 a 和 b 的引用次数都是 2,fn 执行完毕后,两个对象都已经离开环境,在标记清除方式下是没有问题的,但是在引用计数策略下,因为 a 和 b 的引用次数不为 0,所以不会被垃圾回收器回收内存,如果 fn 函数被大量调用,就会造成内存泄露。在 IE7 与 IE8 上,内存直线上升。
6. 谈谈闭包
闭包是一个封闭的空间,里面存储了在其他地方会引用到的该作用域的值,在 JavaScript 中是通过作用域链来实现的闭包。
只要在函数中使用了外部的数据,就创建了闭包,这种情况下所创建的闭包,我们在编码时是不需要去关心的。
我们还可以通过一些手段手动创建闭包,从而让外部环境访问到函数内部的局部变量,让局部变量持续保存下来,不随着它的上下文环境一起销毁。
使用闭包可以解决一个全局变量污染的问题。
如果是自动产生的闭包,我们无需操心闭包的销毁,而如果是手动创建的闭包,可以把被引用的变量设置为 null,即手动清除变量,这样下次 JavaScript 垃圾回收器在进行垃圾回收时,发现此变量已经没有任何引用了,就会把设为 null 的量给回收了。
核心作用
使变量可以保留在内存中,不被释放掉。也因为如此,可能会造成内存泄漏
7. 作用域和作用域链
JavaScript有三种作用域:全局作用域、函数作用域、块级作用域
作用域表示了变量(或者叫资源)的可访问性
作用域是分层的,内层作用域可以访问外层作用域的变量,反之则不行
全局作用域
- 最外层函数和在最外层函数外面定义的变量拥有全局作用域
- 所有未定义直接赋值的变量自动声明为拥有全局作用域
- 所有 window 对象的属性拥有全局作用域
函数作用域
是指声明在函数内部的变量,和全局作用域相反,局部作用域一般只在固定的代码片段内可访问到,最常见的例如函数内部
块级作用域
块级作用域可通过新增命令 let 和 const 声明,所声明的变量在指定块的作用域外无法被访问。
块级作用域在如下情况被创建:
- 在一个函数内部
- 在一个代码块(由一对花括号包裹)内部
let 声明的语法与 var 的语法一致。你基本上可以用 let 来代替 var 进行变量声明,但会将变量的作用域限制在当前代码块中。块级作用域有以下几个特点:
- 声明变量不会提升到代码块顶部
- 禁止重复声明
当访问一个变量时,编译器在执行这段代码时,会首先从当前的作用域中查找是否有这个标识符,如果没有找到,就会去父作用域查找,如果父作用域还没找到继续向上查找,直到全局作用域为止。这种一层一层的关系,就是作用域链
作用域链表达了变量查找的过程,保证了当前执行的作用域对符合访问权限的变量和函数的有序访问
8. new 操作符具体做了什么
运算符创建一个用户定义的对象类型的实例或具有构造函数的内置对象的实例。
new 关键字会进行如下的操作:
步骤 1:创建一个空的简单 JavaScript 对象,即 { }
步骤 2:链接该对象到另一个对象(即设置该对象的原型对象);
步骤 3:将步骤 1 新创建的对象作为 this 的上下文
步骤 4:如果该函数没有返回对象,则返回 this
9. 谈谈 Promise
- 是异步编程的一种解决方案,比传统的解决方案——回调函数和事件——更合理且更强大。它最早由社区提出并实现,ES6将其写进了语言标准,统一了用法,并原生提供了Promise对象。
特点
对象的状态不受外界影响 (3 种状态)
Pending 状态(进行中)
Fulfilled 状态(已成功)
Rejected 状态(已失败)
一旦状态改变就不会再变 (两种状态改变:成功或失败)
- Pending -> Fulfilled
- Pending -> Rejected
8.TS 中 type 和 interface 的异同
相同点
- 都可以描述一个对象或函数
- 都允许扩展(extends),interface 使用 extends,type 使用等号(=)
不同点
- type 可以声明基本类型别名,联合类型,元组等,interface 则不能
- interface 可以合并(覆写),type 不能
9.call、bind、apply 的作用和区别
TIP
fn.apply(this, [args_array])
fn.call(this, arg1, arg2, ...)

fn.bind(this, arg1, arg2, ...)()
or
const newFn = fn.bind(this, arg1, arg2, ...)fn.apply(this, [args_array])
fn.call(this, arg1, arg2, ...)
fn.bind(this, arg1, arg2, ...)()
or
const newFn = fn.bind(this, arg1, arg2, ...) call 和 apply
都可以改变 this 的指向,并且改变后立即执行,因此是临时改变
但传参方式有所不同
bind
bind 的返回值是一个函数,此函数已经改变了 this 指向,因此是永久更改
不会立即执行,需要手动调用
10.谈谈 ES6 的箭头函数
消除了普通函数的二义性
普通函数
既可以通过 () 执行调用,也可以通过 new 调用
因此意义不明,可读性差
this:有自己的 this 指向,指向调用者,即存在原型
箭头函数
无法通过 new 调用,只能作为函数执行调用,意义明确
this:没有自己的 this,使用的是父级作用域的 this,即不存在原型
11. js 高阶函数? 函数柯里化?
函数的本质
对流程的封装,使其具有通用性
先看一个普通的例子,createMap()作用是把数组的每一项翻指定的倍数
const arr1 = [1, 2, 3, 6]

function createMap(arr, rate) {
  const newArr = []
  arr.forEach((item) => {
    newArr.push(item * rate)
  })

  return newArr
}

console.log(createMap(arr1, 2))
// [ 2, 4, 6, 12 ]
const arr1 = [1, 2, 3, 6]
function createMap(arr, rate) {
const newArr = []
arr.forEach((item) => {
newArr.push(item * rate)
})
return newArr
}
console.log(createMap(arr1, 2))
// [ 2, 4, 6, 12 ]假如需要把数组的每一项转换成指定的格式,比如{ name: name[item] },显然 rate 不适用
↓
function createMap(arr, mapper) {
	const newArr = []
	arr.forEach(item => {
		newArr.push(mapper(item))
	})

	return newArr
}

console.log(createMap(arr1, n => n * 2)) // [ 2, 4, 6, 12 ]
console.log(createMap(arr1, n => ({ name: `name${n}` })))
// [
//   { name: 'name1' },
//   { name: 'name2' },
//   { name: 'name3' },
//   { name: 'name6' }
// ]
function createMap(arr, mapper) {
const newArr = []
arr.forEach(item => {
newArr.push(mapper(item))
})
return newArr
}
console.log(createMap(arr1, n => n * 2)) // [ 2, 4, 6, 12 ]
console.log(createMap(arr1, n => ({ name: `name${n}` })))
// [
// { name: 'name1' },
// { name: 'name2' },
// { name: 'name3' },
// { name: 'name6' }
// ]↓
函数柯里化写法
function createMap(arr) {
	return function (mapper) {
		const newArr = []
		arr.forEach(item => {
			newArr.push(mapper(item))
		})

		return newArr
	}
}

const newArr = createMap(arr1)(n => ({ id: n }))
console.log(newArr) // [ { id: 1 }, { id: 2 }, { id: 3 }, { id: 6 } ]
function createMap(arr) {
return function (mapper) {
const newArr = []
arr.forEach(item => {
newArr.push(mapper(item))
})
return newArr
}
}
const newArr = createMap(arr1)(n => ({ id: n }))
console.log(newArr) // [ { id: 1 }, { id: 2 }, { id: 3 }, { id: 6 } ]柯里化是一种将使用多个参数的一个函数转换成一系列使用一个参数的函数的技术
实现思路
判断当前传入函数的参数个数 (args.length) 是否大于等于原函数所需参数个数 (fn.length) ,如果是,则执行当前函数;如果是小于,则返回一个函数
function curry(fn, ...args) {
  return args.length >= fn.length ? fn(...args) : (..._args) => curry(fn, ...args, ..._args)
}
function curry(fn, ...args) {
return args.length >= fn.length ? fn(...args) : (..._args) => curry(fn, ...args, ..._args)
}函数柯里化的优点
函数更加灵活和可重用。通过柯里化,可以将一个多参数的函数转换为一系列单参数的函数,使函数更加灵活和可重用
可以避免重复的代码。通过柯里化,可以避免在调用函数时重复地传递参数,从而避免了重复的代码
函数柯里化的缺点
可能会降低性能。通过柯里化,函数的性能可能会降低,因为需要额外的内存来存储函数的返回值和参数
可能会增加代码复杂度。通过柯里化,可能会增加代码的复杂度,因为需要处理额外的参数和函数返回值
12. JS数组去重
// 数字或字符串数组去重,效率高
function unique(arr) {
    var result = {}; // 利用对象属性名的唯一性来保证不重复
    for (var i = 0; i < arr.length; i++) {
        if (!result[arr[i]]) {
            result[arr[i]] = true;
        }
    }
    return Object.keys(result); // 获取对象所有属性名的数组
}

// 利用ES6的Set去重,适配范围广,效率一般,书写简单
function unique(arr) {
    return [...new Set(arr)]
}

// 花活
const uniqueArr= (arr) => arr.reduce((prev, cur) => prev.includes(cur) ? prev : [...prev, cur], []);
// 数字或字符串数组去重,效率高
function unique(arr) {
var result = {}; // 利用对象属性名的唯一性来保证不重复
for (var i = 0; i < arr.length; i++) {
if (!result[arr[i]]) {
result[arr[i]] = true;
}
}
return Object.keys(result); // 获取对象所有属性名的数组
}
// 利用ES6的Set去重,适配范围广,效率一般,书写简单
function unique(arr) {
return [...new Set(arr)]
}
// 花活
const uniqueArr= (arr) => arr.reduce((prev, cur) => prev.includes(cur) ? prev : [...prev, cur], []);